Artykuł, który może zainteresować wszystkich programistów 👀! Przedstawię 7 porad, które pokażą Ci jak pisać dobry kod źródłowy 🔔! Oczywiście pojęcie "dobry" jest względne, bo każdy z nas będzie interpretować je na swój sposób, lecz chciałem wyodrębnić kilka ogólnych "punktów zaczepienia", które nie są ograniczone do konkretnego paradygmatu ⚓. Nie będzie żadnych zaawansowanych zagadnień, tylko raczej szybkie do pokazania punkty na co można zwrócić uwagę, aby przećwiczyć i być może uznać, że to rzeczywiście może pomóc ❤️. Zapraszam do lektury 🙂!
PRZEDSTAWIAM 7 PORAD JAK PISAĆ DOBRY KOD!
Porady jakie tu zawarłem, nie są żadną kompilacją zagadnień powszechnie uznawanych za dobre praktyki ⚠️. To będzie raczej własne opracowanie zestawu punktów w oparciu o moje doświadczenie, na jakie warto zwrócić uwagę podczas programowania (bądź nauki programowania), a które mogą naprawdę zwiększyć jakość naszego kodu 📈.
JAKIE SĄ PORADY W PISANIU DOBREGO KODU ŹRÓDŁOWEGO?
Oto 7 porad z mojej strony, które warto rozważyć jeśli zależy Ci na pisaniu kodu źródłowego w sposób bardziej profesjonalny 👇:
- Nadawaj dokładne i adekwatne do zastosowania nazwy wszelkim konstrukcjom,
- Stosuj wyraźne wcięcia i odstępy,
- Stosuj skrócone operatory przypisania (jeśli to możliwe),
- Twórz jak najmniejsze bloki kodu,
- Unikaj duplikacji tego samego kodu,
- Dąż do tworzenia reużywalnych fragmentów kodu,
- Grupuj dane dotyczące jednego obiektu czy kontekstu.
A teraz opiszę szerzej każdy z przytoczonych punktów. Przykłady kodów źródłowych będę prezentował na języku C ℹ️.
NADAWAJ DOKŁADNE I ADEKWATNE DO ZASTOSOWANIA NAZWY WSZELKIM KONSTRUKCJOM
Jest to jedna z tych rzeczy, które brzmią jak oczywista sprawa, a jednak wśród początkujących można zauważyć, że tylko pozornie.
Gdy zależy nam na szybkim przetestowaniu działania kodu, często przypisujemy dowolne nazwy tworzonym zmiennym i funkcjom, a gdy okaże się, że kod działa jak należy...zapominamy poprawić jego szczegóły i idziemy dalej 😐. To samo ryzyko powstaje przy refaktoryzacji kodu, gdy tylko zmodyfikujemy instrukcje nadające inny kształt działania programu, a nazwy już niekoniecznie 😅.
Przykładowo taki scenariusz: chcesz wyznaczyć liczbę doręczonych wiadomości do użytkowników 📩.
Najpierw zmienna. Możesz ją utworzyć o takiej postaci 👇:
int x;Czy po 2 tygodniach powrotu do tego kodu, potrafił(a)byś stwierdzić (bez komentarzy i instrukcji wokół) do czego służy ta zmienna 🙂? Byłoby ciężko 😁.
Pójdźmy inną drogą 👇:
int deliveredMessages;Dużo lepiej, bo przynajmniej widać czego dotyczy 👍. Natomiast chodzi o liczbę dostarczonych wiadomości, a powyższa nazwa troszkę sugeruje posiadanie informacji o każdej z tych wiadomości (np. równie dobrze pasowałaby do listy zawierającej obiekty wiadomości).
To może w ten sposób 👇:
int numberOfDeliveredMessages;To jest wyczerpująca nazwa ✅. Mamy określenie o jaki rodzaj informacji chodzi (abstrakcyjnie, bez narzucania czy to "int", czy "float") i czego dotyczy (kontekst). Dzięki takiemu podejściu, po powrocie do tego samego kodu po dłuższym czasie, jest zdecydowanie mniejsze ryzyko, że będziesz się zastanawiać godzinami po co to zostało dodane 😊.
Teraz funkcja. Dajmy na to, że informację o liczbie dostarczonych wiadomości zwraca nam funkcja. Moglibyśmy nazwać ją tak (pomijam blok instrukcji, aby skoncentrować się na jedynym ważnym elemencie w tej chwili) 👇:
int deliveredMessages()Nie polecam 🚫. Przyjmuje się, że najlepiej aby nazwy były pisane w formie rozkazującej określającej czynność typu "zrób", "pobierz" czy "spróbuj". Bardziej w taki sposób 👇:
int getDeliveredMessages()Jest OK, trzymamy się formy czasownikowej, lecz ponownie jest szansa na błędną interpretację po samej nazwie, gdybyśmy ją wywoływali z innego pliku, ponieważ chodzi o liczbę, a tu znowu możemy pomyśleć o całych obiektach. Fakt, że typ zwracanej wartości może sugerować o co naprawdę chodzi, natomiast zawsze dobrze jest to podkreślić używając właśnie nazwy (szczególnie, gdy nie wszystkie języki wspierają pisanie typu danych np. Python ⚠️) 👍.
To może tak 👇:
int getNumberOfDeliveredMessages()Tak lepiej wygląda ✅. Występuje forma czasownikowa, rodzaj informacji (wynikający nie tylko z samego typu danych, lecz także z nazwy) oraz czego to dotyczy. Widać, że nazwa jest dużo dłuższa (co może budzić zastrzeżenia), natomiast czytelność powinna być ważniejsza od używania skrótów 🙂.
Nadawaj dokładne nazwy wszystkim konstrukcjom, aby jednoznacznie określały w jakim celu zostały powołane. W mojej ocenie, samo nadawanie dobrych i precyzyjnych nazw wszystkiemu co zawieramy w kodzie, już jest "sztuką samą w sobie", którą należy trenować tak długo, aż osiągniemy zdumiewający efekt 🌟.
Jeżeli nad jednym programem pracuje zespół, pamiętaj że nie każda osoba może znać się na programowaniu. Aby dać szansę na zrozumienie tego, co się dzieje w kodzie, należy pozbyć się wszelkiej dezinformacji i niejednoznaczności, a można to zrobić poprzez umiejętne nazywanie 👍. Ktoś może znać język, lecz nie wie w jaki sposób piszesz kod. Każdy z nas posiada inne przyzwyczajenia i kieruje się swoim własnym stylem.
Kolejną zaletą takiego podejścia jest brak "przerzucania" wyjaśniania kodu na komentarze, dzięki czemu ich obecność może być całkowicie pominięta, skoro kod sam tłumaczy jaką pełni funkcję 😊.
Na koniec ważna rzecz ⚠️. Nie sugeruję, że to jedyne słuszne podejście. Tak jak pisałem, to jest też kwestia własnego gustu i ulubionego stylu pisania. Może być też narzucony jakiś inny przez standardy w firmie w jakiej pracujesz lub przyjdzie Ci pracować. Ja tylko zostawiam swoją propozycję, aby pokazać inne spojrzenie na ten temat, a być może Ci się spodoba i zechcesz nim się kierować 👍.
STOSUJ WYRAŹNE WCIĘCIA I ODSTĘPY
To jest punkt odnoszący się do formatowania kodu, który wyraźnie tłumaczy o co chodzi 😉.
Pisząc instrukcję warunkową, funkcję czy każdą inną konstrukcję zawierającą odrębny blok kodu, zadbaj o takie rozmieszczenie klamerek (bądź innych oznaczeń początku i końca bloku, które zależą od języka programowania), aby było bardzo wyraźnie widać które instrukcje go dotyczą 👀. Oprócz tego, niech te oznaczenia będą spójne i jednolite w rozumieniu odstępów od początku wiersza (w spacjach czy tabulatorach). Powód dlaczego o tym wspominam, określę jednym słowem: czytelność.
Dam przykład. Mamy za zadanie zbadać każdy element tablicy czy powinniśmy go obsłużyć po spełnieniu pewnego warunku i w razie potrzeby to uczynić. Kod z jakim moglibyśmy się spotkać, mógłby wyglądać tak 👇:
for (int i = 0; i < 10; i++){
 // instrukcje
  if (...)        {
   // instrukcje
     }
}
Zapis jest niechlujny, a zawarte odstępy i znaki wyznaczające granice bloków kodu rozmieszczone w różnych miejscach powodują, że przy dużo większej liczbie wierszy byłoby trudniej to czytać ❌. Przy większych rozgałęzieniach problem tylko się potęguje 😐.
Aby uczynić ten kod o wiele lepszym, wystarczy dbać o konsekwencję w tworzeniu wcięć i bloków kodu 🙂. Jeżeli wstawiamy jeden tabulator na początku, to kończmy również jednym tabulatorem. Jak mamy zwyczaj umieszczania klamerki otwierającej tuż pod nagłówkiem danej konstrukcji (instrukcja warunkowa, instrukcja "switch" itd.), to róbmy tak w każdym przypadku na przestrzeni całego projektu i wszystkich plików z kodem 😉!
Oto ten sam kod przy konsekwentnym trzymaniu się jednolitych wcięć i umiejscawiania znaków klamrowych 👇:
for (int i = 0; i < 10; i++)
{
	// instrukcje

	if (...)
	{
		// instrukcje
	}
}
Wspomnę na koniec, że korzystając z określonego języka, warto zapoznać się z konwencjami jakie mogą dotyczyć miejsca wstawiania klamer otwierających. Na przykład w językach Java i JavaScript zaleca się umieszczanie ich w tym samym wierszu co nagłówek konstrukcji, do którego należy dany blok 👇:
if ([warunek]) {
	// instrukcje
}
Wtedy dobrze jest dostosować styl pisania, aby być w pełni zgodnym z zasadami, do których spora liczba programistów już zdążyła się przyzwyczaić 👍.
Staraj się, aby Twój kod wyglądał tak pięknie, jakby miał być prezentowany na wystawie sztuk artystycznych 😊. Jak jest porządnie sformatowany, wtedy jest czytelny. A jak jest czytelny, wtedy można na nim działać ☑️.
STOSUJ SKRÓCONE OPERATORY PRZYPISANIA (JEŚLI TO MOŻLIWE)
Ten punkt odnosi się ponownie do zwiększenia czytelności kodu, natomiast też idzie w stronę komfortu dla nas, programistów.
Wiele języków wysokiego poziomu, poza klasycznymi instrukcjami przypisania wartości do zmiennej mającymi na celu tak naprawdę jej modyfikację, posiada wygodne skrócone zapisy, które pozwalają wykonać to samo, tylko używając mniejszej liczby znaków 🙂.
Prosty przykład to dodawanie liczby do zmiennej typu całkowitoliczbowego. To tradycyjny sposób zapisu 👇:
x = x + 5;Instrukcja składniowo jest napisana poprawnie, natomiast kiedy zmienna posiada długą nazwę, to możemy czuć się lekko poirytowani pisaniem drugi raz tego samego 🙂.
Dużo języków oferuje alternatywny zapis, który wygląda tak 👇:
x += 5;Ten sam efekt, mniej fatygi ✅. Nie trzeba nic więcej tłumaczyć 😊.
Jeżeli operacja arytmetyczna dotyczy zwiększenia bądź zmniejszenia wartości o 1, to można użyć operatorów inkrementacji (dodawania) i dekrementacji (odejmowania) 👇:
x++;To jeszcze bardziej skraca cały zapis ✅. Same wyżej wspomniane operacje dzielą się dodatkowo na "pre" i "post", lecz po więcej szczegółów skieruję Cię do załączonych materiałów.
Nie wszystkie języki posiadają przedstawione operatory 🚫. Python dla przykładu posiada skrócone operatory przypisania, natomiast nie można w nim stosować inkrementacji czy dekrementacji. Z kolei Lua nie posiada ani jednego, ani drugiego 😅, więc miej tę świadomość, że nie znajdziesz wszędzie takich skrótów ❌. Dlatego napisałem "jeśli to możliwe" 😉. Jak możliwe, to korzystaj 😄!
TWÓRZ JAK NAJMNIEJSZE BLOKI KODU
Przechodzimy do kolejnego punktu, w którym także hasłem przewodnim jest "czytelność", lecz także "zarządzanie" 🔥.
Każdy blok kodu jaki istnieje w Twoim programie, powinien być tak mały, jak to tylko możliwe. Dobry kod, to między innymi rozłożony na czynniki pierwsze, a to możemy uczynić poprzez staranną dbałość o liczbę wierszy na blok kodu 🏆. Tutaj chodzi o dosłownie każdy blok kodu - od instrukcji warunkowej, przez pętle, aż do funkcji. Nawet na pojedynczy plik z kodem źródłowym można patrzeć, jak na blok (o tym trochę dalej w tym punkcie).
Im bardziej kod będzie wydzielony na małe części, tym dużo przyjemniej będzie go modyfikować i usuwać znalezione błędy ➕. To może zająć dużo czasu, w zależności od tego jak starannie się do tego przyłożymy, natomiast na dłuższą metę tylko da Ci poczucie większej kontroli nad całością i zmniejszy prawdopodobieństwo, że jakiś fragment okaże się zbyt zawiły, aby mieć odwagę go dotknąć 😅.
Oto przykład. Potrzebujemy uzyskać graficzny wykres na podstawie danych z pliku. Mamy funkcję, która zajmuje się jednocześnie nawiązywaniem połączenia z plikiem, pobieraniem z niego danych i tworzeniem wykresu, a kod takiej funkcji może na przykład przyjmować poniższą postać 👇:
void displayChart()
{
	// instrukcje nawiązywania połączenia z plikiem o podanej ścieżce

	// instrukcje pobierania danych z pliku

	// instrukcje generowania wykresu
}
Pominąłem szczegóły, gdyż to zależy od języka, stosowanych wtyczek lub bibliotek i od stylu pisania.
Nienajlepszy pomysł ⛔. Co w sytuacji, gdy w którejś z tych 3 czynności trzeba będzie coś zmienić albo usunąć znaleziony błąd 😲? Nawet przyjmijmy, że uda się dopisać ważny fragment, który potrzebował dodatkowych 100 linijek w tej funkcji. Gdy wtedy coś będzie wymagać zmian, problem tylko się nawarstwi jak kula śnieżna 😬. Im dalej w las, tym będzie coraz gorzej ❌.
Można temu zaradzić w prosty sposób (aczkolwiek może być czasochłonny ⌚). Po prostu podziel tę funkcję na 3 mniejsze bloki, a instrukcje zamień na wywołania funkcji 👇:
void displayChart()
{
	openFile();
	readDataFromFile();
	createChart();
}
Postępując w ten sposób, zmniejszasz wielkość bloku kodu przez co jest łatwiejszy w kontroli ✅. W połączeniu z dobrymi nazwami, znacznie ułatwiasz zrozumienie tego fragmentu przez inne osoby 🚀! Jeżeli się zdarzy, że ta wydzielona funkcja ma w sobie zbyt wiele instrukcji, możesz pójść krok dalej i ponownie ją podzielić 😄.
Przykład nie bierze pod uwagę różnych scenariuszy jakie mogą się zdarzyć (takie jak brak pliku o podanej ścieżce czy formatowanie danych). Tutaj pokazuję tylko jak można podejść do kodu, tak aby był bardziej zorganizowany 👍. Ponadto instrukcje wewnątrz bloku mogą być pomieszane ze sobą i wtedy w pierwszej kolejności trzeba je uporządkować, aby potem móc działać.
Nie ma określonego z góry limitu wierszy na blok kodu, natomiast radziłbym starać się nie przekraczać 10 linijek. To jest taki limit, że po jego przekroczeniu jest coraz trudniej spojrzeć na całość nie przesuwając wzroku 📉. Ważne też jest, aby nie wpadać w perfekcjonizm i nie próbować tego skracać w 100% przypadków, a raczej dążyć do przeważającej większości pisania w ten sposób 😉.
Podczas podziału kodu trzeba uważać, aby też nie przesadzić z wielkością wierszy na jeden plik źródłowy albo skrypt ⚠️. Gdy zacznie rosnąć do niebotycznych wielkości, najlepiej zastosować ten sam podział tylko w odniesieniu do plików, choć to może być już dużo trudniejsze do zrealizowania 💥. Tutaj podejście zależy od paradygmatu jakim się posługujesz. Na przykład w programowaniu obiektowym występują klasy, które zazwyczaj umieszczamy w osobnych plikach i w taki sposób dzielimy kod na mniejsze części 👍.
Nie rób monolitów - przestaw się na tworzenie małych modułów, z których zaczniesz budować większe fragmenty programu 🧩.
UNIKAJ DUPLIKACJI TEGO SAMEGO KODU
Tu dotykamy optymalizacji, czyli jak pisać, aby osiągnąć jakiś cel, lecz z jak najmniejszym zużyciem zasobów komputera 🧠.
Bywa, że mamy taką sytuację, w której wykonujemy szereg obliczeń i jakieś wyrażenie przyjmuje tę samą postać (np. kwadrat wartości zmiennej). Jak napiszemy to samo dwukrotnie 👇:
[jedna instrukcja korzystająca z wyrażenia x*x]

// inne instrukcje

[druga instrukcja korzystająca z wyrażenia x*x]
to dla nas nie robi to różnicy, bo wiemy czego się spodziewać. Dla komputera, owszem. Gdy "widzi" to samo wyrażenie w wielu miejscach, nie działa tak jak my, że sobie policzymy raz w głowie i już znamy wynik. Musi za każdym razem policzyć to samo wyrażenie, nawet jeśli jest identyczne! Wykona dwukrotnie to samo i zrobi to niepotrzebnie 💥!
Gdy kiedykolwiek zauważysz, że jakiś zapis jest powtórzony jota w jotę i pojawia się przynajmniej 2 razy (albo więcej 🙂), to przypisz wyrażenie do zmiennej i podstaw ją we wszystkich wystąpieniach 👇:
int squaredX = x*x;

[jedna instrukcja korzystająca ze zmiennej squaredX]

// inne instrukcje

[druga instrukcja korzystająca ze zmiennej squaredX]
Wtedy komputer będzie musiał obliczyć dane wyrażenie tylko jeden raz, a potem gdy zajdzie potrzeba, możemy sięgnąć po tę wartość i podstawić ✅.
Tylko uwaga na jedną rzecz ⚠️! Pamiętaj, że taka zmienna przechowa wartość jaka jest w aktualnym stanie (przechowuje taką "stopklatkę" 🎬). To oznacza, że jeżeli pomiędzy powtórzonymi wyrażeniami pojawia się modyfikacja składnika biorącego w nich udział (np. jako inkrementacja) 👇:
x++;to wtedy oba te wyrażenia, choć przyjmują identyczną postać, zwrócą inny wynik 🔥! W takiej sytuacji należy odświeżyć wynik wyrażenia albo przypisując je "na nowo" (tuż po zmianie wartości bazowej), albo od razu modyfikując samo wyrażenie, o ile to możliwe 💡.
Powtarzanie się kodu może dotyczyć też funkcji i to po stronie zarówno tworzenia, jak i wywoływania 😲! Jeżeli widzisz dowolny fragment wielu instrukcji, który powtarza się w jakiejś formie 👇:
printf("%d\n", a);
printf("%d\n", b);
printf("%d\n", c);
to spróbuj utworzyć funkcję, która pozwoli uprościć ciąg parametrów 👇:
void printInt(int integer)
{
	printf("%d\n", integer);
}
i zamienić je na wywołania tej funkcji, ograniczając listę parametrów tylko do tego, co się zmienia 👍.
Eliminuj powtarzanie się. Łącz ze sobą wszystko co się da i sprowadzaj wyrażenia do najprostszej formy!
DĄŻ DO TWORZENIA REUŻYWALNYCH FRAGMENTÓW KODU
Kolejna kwestia związana z pisaniem kodu wysokiej jakości 🌟. Reużywalność odnosi się do konstrukcji, które można zastosować do każdego celu i nie narzucają żadnego kontekstu. Więcej informacji o samym terminie znajdziesz w załączonym materiale, a tutaj tylko streszczę o co chodzi.
Zdarza się, że jeden moduł da się zastosować do dwóch zupełnie innych sytuacji i to niezależnie od tego, jak bardzo one kontrastują. Przykładem jest losowanie liczb (konkretniej, to pseudolosowanie) 🎲. Możemy go użyć do przeróżnych celów, takich jak 👇:
- symulacja rzutu kością (liczba od 1 do 6),
- generacja wyglądu lub ukształtowania czegoś (wpływ na atrybuty lub przydzielanie tzw. "ziarna"),
- efekt szansy na krytyczne uderzenie postaci w grze (sprawdzenie czy losowa wartość od 0 do 100% nie przekracza progu).
Każdy z przykładów nie ma ze sobą nic wspólnego, a losowanie mimo tego, potrafi zapewnić oczekiwane działanie dla każdego przypadku 🎉! Możemy zauważyć, że jest to bardziej narzędzie, a nie konkretna funkcjonalność. Przypomina ona baterię, którą możemy włożyć do lampki, pilota czy latarki i wszędzie przyniesie ten sam efekt 💡.
Kod reużywalny to taki, który nie określa okoliczności jego użycia. Może potrzebować jakichś danych albo obiektów, natomiast nie ma ani słowa na temat sytuacji 🚫. A druga rzecz to zapewnienie, że żadne późniejsze modyfikacje (głównie poprzez nowe parametry) nie popsują działania w jakimkolwiek przypadku użycia, który został określony wcześniej.
Dla przykładu, domyślnym działaniem funkcji losującej mogłoby być wyznaczanie wartości z przedziału od 0 do 1 👇:
double getRandomValue()a przy użyciu parametrów wejściowych możemy wpływać na dolną i górną granicę zakresu 👇:
double getRandomValue(double min = 0.0, double max = 1.0)Jeżeli podamy własne wartości, to zostaną uwzględnione przy losowaniu. Jak nie, to sięgnie po domyślne (pisane w takiej formie przed modyfikacją) i też będzie działać 👍. Pamiętaj jednak, że możemy to tak zapisać tylko, gdy język na to zezwala (jeżeli nie, to trzeba zdefiniować dwie osobne funkcje) ⚠️!
Staraj się tworzyć takie moduły, aby służyły jako narzędzie do wielokrotnego zastosowania, a nie sztywno napisana część nadająca się tylko do przypadku X 🎯. Nie zawsze tak się da, natomiast jeżeli widzisz szansę na skonstruowanie kodu w takiej formie, to warto spróbować 😊!
GRUPUJ DANE DOTYCZĄCE JEDNEGO OBIEKTU CZY KONTEKSTU
Dotarliśmy do ostatniej mojej porady, w której słowem klucz jest organizacja 🌟.
Często bywa tak, że pewne zadanie do wykonania wymaga szeregu różnych danych w postaci wielu pojedynczych zmiennych. Dla przykładu, mamy takie dane 👇:
char carBrand[20];
char carModel[20];
char ownerName[20];
char ownerPesel[11];
char ownerSurname[40];
char licensePlateNumber[7];
Przyjmijmy, że są umieszczone w programie w takiej formie, w jakiej są (umieszczone jedna pod drugą). Takie podejście jest nie do końca poprawne, gdyż przypomina sterty plików w jednym katalogu, które nie podlegają żadnemu pogrupowaniu. O ile nazwy są dobrze dobrane, to jeszcze będziemy potrafili ustalić co reprezentuje dana wartość, natomiast wciąż będą to osobne dane, które nie są w żaden sposób połączone.
Dobrze jest zrobić krok do tyłu i zastanowić się czy nie da się "opakować" danych w jakąś strukturę, która będzie je przechowywać. Spróbuj znaleźć do każdej z nich jakieś wspólne hasło, odpowiadając sobie na pytanie "jakiego rodzaju danych dotyczy ta zmienna?".
Gdy w matematyce mówimy o osiach X i Y, to częścią wspólną będzie określenie "współrzędne", czyli obiekt składający się z dwóch wartości, który nazwalibyśmy "punktem" 💡. Wówczas moglibyśmy sobie utworzyć strukturę przyjmującą obie zmienne 👇:
struct Point
{
	float x;
	float y;
};
W ten sposób tworzymy grupę danych, którym nadajemy przyporządkowanie do jakiejś kategorii. To nie tylko sprzyja zmniejszeniu danych w jakiejś centralnej strukturze oraz możliwości ponownego użycia, lecz także pozwala uniknąć modyfikowania listy parametrów funkcji, które potrzebują tej serii danych (albo jej części) 🔥.
Zamiast pisać tak 👇:
void doSomething(float x, float y)możemy wprowadzić jeden parametr jako grupę 👇:
void doSomething(Point point)aby w razie potrzeby "wypakowywać" stamtąd potrzebne dane ❤️. Wtedy gdy dane w środku zostaną zmienione, trzeba będzie tylko zaktualizować ich obsługę 👍.
W zależności od paradygmatu i języka programowania, możemy takie dane wstawić do klasy i skorzystać z nich do grupowania danych. Jeżeli jest kilka możliwości, trzeba się dowiedzieć która z nich będzie najbardziej pasująca i taką się kierować ⏩.
Segreguj dane i twórz dla nich struktury. Gdy są przynajmniej 2 dane, które mają wspólny mianownik, warto stworzyć dla nich grupę jaką można klonować i podstawiać do obiektów, funkcji i wszystkich innych konstrukcji.
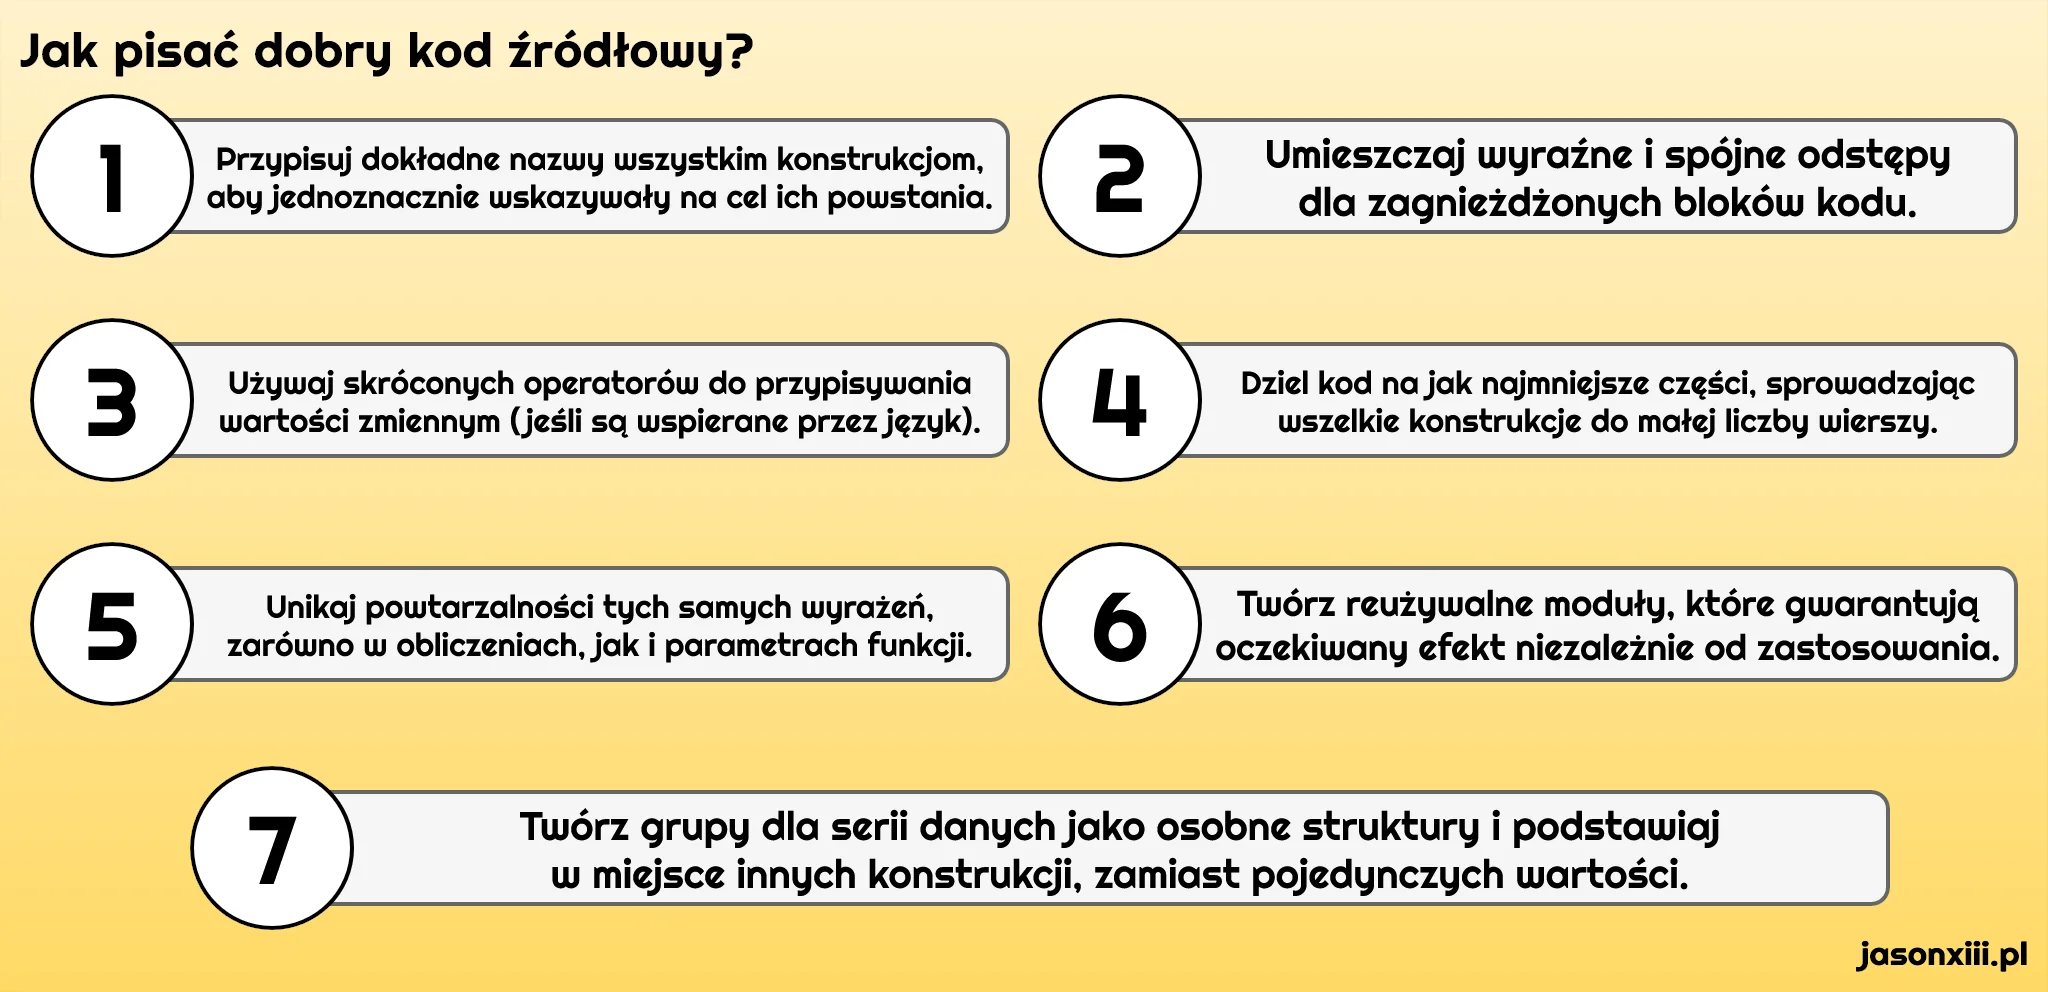 |
Oto 7 porad z mojej strony, które znacznie podnoszą jakość kodu źródłowego!
Koniec materiału. Zaprezentowałem Tobie 7 porad jak pisać dobry kod źródłowy i są to wskazówki powstałe na bazie mojej praktyki, które uważam za naprawdę pomocne w pracy programisty 📈. Może być na początku trudno się przyzwyczaić do odmiennego podejścia (jeśli będziesz chciał(a) nim podążać), jednak naprawdę warto ➕. Twórz kod czytelny, uporządkowany i zorganizowany, a nic nie będzie w stanie Cię przerosnąć - dosłownie i w przenośni 😉.