Tematem tego artykułu są 4 zasady programowania obiektowego, jakie musi znać każdy programista 💥! Poznasz termin, definicję i krótki przykład do każdej z nich, tak abyś mógł/mogła zrozumieć ich znaczenie. Więc, zapraszam 😁!
PRZEDSTAWIAM 4 ZASADY PROGRAMOWANIA OBIEKTOWEGO!
Zanim przejdę do zasad, przybliżę krótko samo pojęcie programowania obiektowego, które jest jednym z najpopularniejszych podejść do programowania aplikacji dowolnego typu 🌟.
CZYM JEST PROGRAMOWANIE OBIEKTOWE?
Programowanie obiektowe (nazywane też paradygmatem obiektowym), to sposób pisania kodu w którym dominuje podział na klasy i obiekty. Taka forma jest jedną z najbardziej powszechnie stosowanych na świecie głównie dlatego, że jest intuicyjna i prosta do przełożenia ze świata rzeczywistego, aby maksymalnie ją odwzorować. Gdy patrzymy na jakiś przedmiot np. lampkę w pokoju, to potrafimy bez problemu określić dwie kluczowe sprawy: jaki teraz ma stan i co potrafi zrobić. Jej stanem byłby aktualny wygląd (czy nie jest zepsuta) i pozostały poziom baterii 📶, a jej "zdolność" to gaszenie i zapalanie po przełączeniu przycisku ⏏️. My jako ludzie możemy oddziaływać na lampkę poprzez interakcję czy jej zniszczenie (umyślne lub nie) 💥. Przełożenie tego na kod jest jasne i klarowne, stąd takie podejście jest chętnie stosowane 👍.
Fundamentalną częścią kodu pisanego obiektowo jest klasa, czyli szablon dla obiektów jakie są tworzone na jej podstawie (można by ją określić "fabryką") 🏭. Obiekt z kolei, to pojedyncza kopia klasy, z której powstaje 💡. Klasa składa się ze stanu (czyli serii zmiennych nazywanych "polami") oraz czynności (czyli funkcji, określanych jako "metody"). Poprzez skorzystanie z konstruktora klasy dla lampki, czyli metody tworzącej pojedynczy obiekt, tworzymy nowy egzemplarz lampki 🆕. Po powiązaniu z obiektem typu "człowiek", może przez niego podlegać modyfikacjom wymienionym wyżej jako przełączanie jej stanu działania (wł./wył.) czy zniszczenie, ponieważ oba skutki mogą zostać wywołane przez człowieka, lecz nie na odwrót. W ten sposób powstaje relacja pomiędzy dwoma obiektami, która może polegać na wymianie informacji czy oddziaływaniu (tak jak w tym przykładzie) 🔀.
Tak w ogromnym uproszczeniu wygląda programowanie obiektowe 😊. To teraz czas przybliżyć Ci 4 święte zasady 🔍!
JAKIE ISTNIEJĄ ZASADY W PROGRAMOWANIU OBIEKTOWYM?
Oto 4 zasady programowania obiektowego, które uchodzą za standard w wymienionym paradygmacie i konieczna jest ich dobra znajomość 👇:
- Hermetyzacja (enkapsulacja),
- Dziedziczenie,
- Abstrakcja,
- Polimorfizm (wielopostaciowość).
Wyjaśnię teraz każdą z nich w szerszym zakresie, przy czym to będzie krótkie wyjaśnienie wraz z przekierowaniem do osobnego artykułu, tak aby tutaj tylko pokazać szybko każdą z nich ⚠️.
HERMETYZACJA (ENKAPSULACJA)
Hermetyzacja (nazywana też "enkapsulacją" i "kapsułkowaniem"), to dokładniej ujmując, zapewnienie ochrony danych klasy przed dostępem i modyfikacją z zewnątrz (poza klasą). Powodem dla którego jest to bardzo ważne, jest ukrycie przed światem zewnętrznym szczegółów działania danej klasy 🔒. Z punktu widzenia użytkownika nie ma znaczenia to, w jaki sposób klasa wykonuje swoje zadanie, tylko czy będzie w stanie je zrealizować i jaki będzie tego efekt końcowy. Czyli jest skupienie się na "co", a nie na "jak".
Dane koniecznie muszą być zabezpieczone przed wglądem spoza klasy, aby użytkownik korzystający z naszego kodu nie powoływał się na nie bezpośrednio, które w każdej chwili (przy aktualizacji) mogą ulec zmianie 🔥! Lżejszym problemem byłaby zmiana nazwy, lecz dużo gorzej byłoby przy usunięciu którejś z nich, bo na przykład przestała już być potrzebna 😬. Stosując modyfikatory dostępu i metody o dostępie publicznym tworzymy taką "warstwę ochronną", która pozwala użytkownikowi na skorzystanie z klasy, lecz nie ujawniając ani słowa o tym, jak ona działa.
Przykładowym scenariuszem jest złożenie przez obywatela wizyty w urzędzie, aby mógł przełożyć dokument w jakiejś sprawie np. podatkowej 🙂. Gdyby klasa udostępniała wszystkie dane bez żadnej ochrony, to mielibyśmy sytuację, w której urzędnik mówi: "Proszę uprzejmie, już Pana puszczam do komputera, proszę sobie kliknąć w formularz, wypełnić go i wysłać." 😅. Oznaczałoby to, że każdy z ulicy miałby pełen dostęp do danych, do systemu do obsługi formularzy i mógłby zrobić z tym, co tylko by chciał 😬. Taki pracownik złamałby wszystkie procedury i najprawdopodobniej już by nie pracował na tym stanowisku 😆.
W rzeczywistości, to wygląda nieco inaczej 😊. Klient czeka po drugiej stronie osoby obsługującej system i ewentualnie odpowiada na pytania, natomiast sam tego nie obsługuje. Nie wie jak to działa, jakie konkretnie dane trzeba wpisać (nie piszę o oczywistych sprawach, takich jak dane osobowe, tylko np. sygnatury sprawy 💡) i nie musi o tym wiedzieć, aby móc załatwić swoją sprawę. Czyli programistycznie, mielibyśmy publiczną metodę "załatw sprawę w urzędzie", a dane związane z systemem informatycznym i komputer byłyby prywatne (bo wciąż one "należą" do osoby siedzącej przy komputerze) 😉. Wtedy uzyskujemy dwa w jednym - użytkownik może z tego skorzystać i nie musi dokładnie wiedzieć co się tam znajduje ✅.
DZIEDZICZENIE
Dziedziczenie jako zasada programowania obiektowego, odnosi się do tworzenia klas potomnych dziedziczących po innych klasach (stających się wtedy klasami nadrzędnymi), między którymi powstaje relacja "jest". Celem jest nie tylko ustalanie relacji i powiązań pomiędzy klasami od ogółu do szczegółu (co stanowi pierwszy krok do polimorfizmu, który opisuję w osobnym punkcie), lecz także uniknięcie powtórnego definiowania tych samych składowych klasy (pól i metod).
Gdybyśmy na przykład mieli definicję klasy człowieka i programisty, to tu jak najbardziej dziedziczenie byłoby zasadne, ponieważ programista JEST człowiekiem (też ma głowę, ręce i wszystkie inne "dane" dotyczące człowieka) 😊! Dzięki temu, nie musimy ponownie pisać tej samej serii danych i niepotrzebnie powielać tego, co powinno działać identycznie (serce u każdego człowieka pracuje tak samo 🙂) 👍.
Tworząc dziedziczenie po klasie, wszystkie składowe są przekazywane do drugiej klasy i ma ona do nich pełny dostęp, jeśli nie posiadają prywatnego modyfikatora dostępu (może być publiczny bądź chroniony, który dopuszcza możliwość uzyskania dostępu wyłącznie klasom potomnym ⚠️) 🔓. Klasy potomne mogą posiadać własne dodatkowe pola, które wykraczają poza dane klasy bazowej, co działać będzie jak "suma" pól ✅. Programista jako klasa potomna od klasy człowieka, mogłaby na przykład posiadać dodatkową daną odnośnie wiedzy o programowaniu, gdyż to jest coś, czego nie posiada absolutnie każdy człowiek żyjący na tym świecie 😊.
Warto wiedzieć, że dziedziczenie czasami bywa uważane za działanie mogące sprawiać problemy przy bardziej złożonych klasach i zamiast niego lepiej stosować kompozycję, czyli dodanie obiektu do klasy jako dodatkowego pola, aby powstała relacja "ma" (np. lampka MA żarówkę). Tak się robi wówczas, gdy nie chcemy (czy też projektowo nie powinniśmy) tworzyć relacji "jest", a idziemy bardziej w stronę posiadania czegoś przez jakąś klasę. Temat jest na tyle obszerny, że nawet doczekał się własnego określenia anglojęzycznego: "composition over inheritance", więc zostawiam termin dla zainteresowanych, aby można było się zagłębić 😉.
ABSTRAKCJA
Wśród zasad programowania obiektowego mamy abstrakcję - to jest definiowanie składowych klasy bez jakiejkolwiek treści czy konkretnej wartości, co czyni ją "abstrakcyjną" ❓. Jedyną informację jaką posiada abstrakcyjna składowa, to typ danych i to zawsze musi się pojawić! Abstrakcję stosuje się w sytuacjach, gdy podczas określania dziedziczenia pomiędzy klasami, nie da się jednoznacznie określić jaką wartość ma reprezentować dane pole czy też co dokładnie ma wykonywać jakaś metoda na etapie tworzenia klasy bazowej. To jest kluczowy fragment 💥! Jeżeli dowolna składowa klasy jest abstrakcyjna, to wtedy mówimy, że cała klasa jest abstrakcyjna i nie można tworzyć obiektów na jej podstawie ❌.
Można powiedzieć, że taka klasa stanowi "szkielet" dla późniejszych klas, w których można już określić co dana składowa abstrakcyjna ma reprezentować. Kiedy coś jest abstrakcyjne, to innymi słowy oznacza niemożliwe do ścisłego określenia na ogólnym poziomie klasy. Gdy tworzymy klasę potomną, która pochodzi od klasy abstrakcyjnej, to wymusza na nas klarowne zdefiniowanie jaką wartość czy treść każda składowa abstrakcyjna ma posiadać. Jeżeli tworzona klasa potomna nie jest abstrakcyjna, kompilator nie dopuści do uruchomienia programu, dopóki wszystkie abstrakcyjne dane nie zostaną jasno zdefiniowane ⛔.
Przykładowa sytuacja, to projektowanie modelu poruszania się dla różnych typów zwierząt. Gdybyśmy mieli klasę bazową "zwierzę", to ciężko byłoby cokolwiek powiedzieć o jakimś ogólnym systemie poruszania się zwierzęcia, ponieważ każde z nich jest inne. Jedne poruszają się na czterech łapach, inne skaczą przy przemieszczaniu się, inne latają, a jeszcze inne poruszają się pod wodą. Nie ma szans na jakiekolwiek konkretne określenie (w postaci instrukcji) jak w klasie bazowej zwierzę może się poruszać 🚫. Szczegóły dotyczące tego zachowania możemy określić dopiero przy klasach potomnych, chyba że one same również są abstrakcyjne i wtedy ta odpowiedzialność za zdefiniowanie instrukcji "spada" na kolejną klasę potomną jaka będzie od niej dziedziczyć. Pamiętaj o tym, że któregoś razu trzeba będzie określić jaką treść musi przyjąć składowa abstrakcyjna!
Koniecznie trzeba wiedzieć o istotnej zasadzie "nabywania" cechy abstrakcji przez klasę ⚠️! Klasa zawsze musi być abstrakcyjna w momencie, gdy dowolna składowa jest abstrakcyjna. Natomiast możemy uczynić klasę abstrakcyjną także wtedy, gdy nie posiada żadnej abstrakcyjnej składowej! Może się zdarzyć, że jesteśmy w stanie określić co powinno się wydarzyć albo jaką przyjąć wartość dla każdej składowej, lecz wyjdzie z etapu projektowania, że lepiej byłoby aby nie zezwalać na tworzenie obiektów powstałych z tej klasy z jakichkolwiek innych powodów 🔥. Czyli krócej rzecz ujmując 👇:
- klasa musi być abstrakcyjna, jeśli występuje dowolna składowa abstrakcyjna (wtedy powstaje wymaganie),
- klasa może być abstrakcyjna, nawet gdy nie posiada żadnej składowej abstrakcyjnej (wtedy jest to poboczne).
Trzeba zaznaczyć jeszcze jeden ważny aspekt. Abstrakcja nie kończy się na etapie klas ⚠️. Hasło odnosi się również do innej konstrukcji: do interfejsów, czyli typów danych zawierających metody abstrakcyjne, które zaimplementowane przez klasy tworzą pewien "kontrakt" (pojęcie określające co i w jakiej formie musi się znaleźć pomiędzy komponentami, aby doszło do oczekiwanego działania programu na zasadzie "zawartej umowy" 📜). To przynosi taki skutek, że klasa jaka implementuje dany interfejs musi określić instrukcje w każdej z metod pochodzących od tego interfejsu i to nazywamy "kontraktem". W ten sposób tworzymy część wspólną dla klas, które hierarchicznie mogą nie mieć ze sobą nic wspólnego (brak dziedziczenia), natomiast charakteryzują się identycznym zachowaniem i po to się stosuje interfejsy 💡.
POLIMORFIZM (WIELOPOSTACIOWOŚĆ)
Dotarliśmy do zasady polimorfizmu (nazywanego zamiennie "wielopostaciowością"). To jest możliwość odwoływania się do obiektów poprzez kilka różnych typów danych z udziałem wiązania dynamicznego (ang. dynamic binding), czyli rozstrzygania "prawdziwego" typu danych na podstawie referencji w czasie działania programu, nie zważając na deklarowany typ danych (wstawiany w momencie deklaracji zmiennej) 🔥. W praktyce oznacza to, iż jeżeli klasa dziedziczy po jakiejś innej (jest klasą potomną) bądź implementuje jakiś interfejs, to zmienna wskazująca na klasę (bo to jest referencja) może przyjmować 3 następujące typy danych 👇:
- klasy potomnej,
- dowolnej klasy bazowej,
- interfejsu.
To z kolei pozwala na odwoływanie się do poszczególnych składowych występujących w każdym z typów danych z osobna, jednocześnie zachowując odniesienie do definicji tych składowych jakie posiada "prawdziwy" typ referencyjny "kryjący się" pod zmienną 🚀. W ten sposób zawsze przedostaniemy się do takiej definicji pola czy metody, jaka została określona w obiekcie typu takiej klasy, z której powstała 🤩!
Dla przykładu możemy mieć klasę nadajnika, która implementuje interfejs z metodą określającą informowanie najbliższych mieszkańców o zbliżającym się zagrożeniu na danym terenie 🚨. Ten sam interfejs implementuje odrębna klasa dla telefonu komórkowego 📱. Po drugiej stronie moglibyśmy mieć system pobierający wszystkie referencje obu klas i dodający do listy z interfejsowym typem danych (to bardzo ważny fragment!). Dzięki temu, możemy z wielu różnych klas wywołać metodę wysyłającą powiadomienie o zagrożeniu (nie wiadomo w jaki sposób, bo to definiuje klasa 😉), a wszystkie te obiekty niczego o sobie nie wiedzą 😊!
Na żadnym etapie działania nie ma ani słowa o którejkolwiek z klas i mimo tego faktu, każde wywołanie tej samej metody "trafi" do właściwej klasy według typu referencyjnego jaki zostanie zidentyfikowany na podstawie wiązania dynamicznego ❤️! Czyli nadajnik obsłuży to na własny sposób, a telefon komórkowy na własny ✅.
Polimorfizm jest bardzo użyteczną cechą programowania obiektowego, ponieważ na niej opiera się zasada "odwrócenia zależności" - jedna z 5 zasad mnemoniku SOLID nakreślająca dobre praktyki jak budować kod elastyczny i potężny (ona występuje już poza tą "czwórką") 📈. Zostawiam tylko wzmiankę na ten temat do poczytania o tym więcej już samodzielnie, aby nie mieszać dwóch różnych wątków.
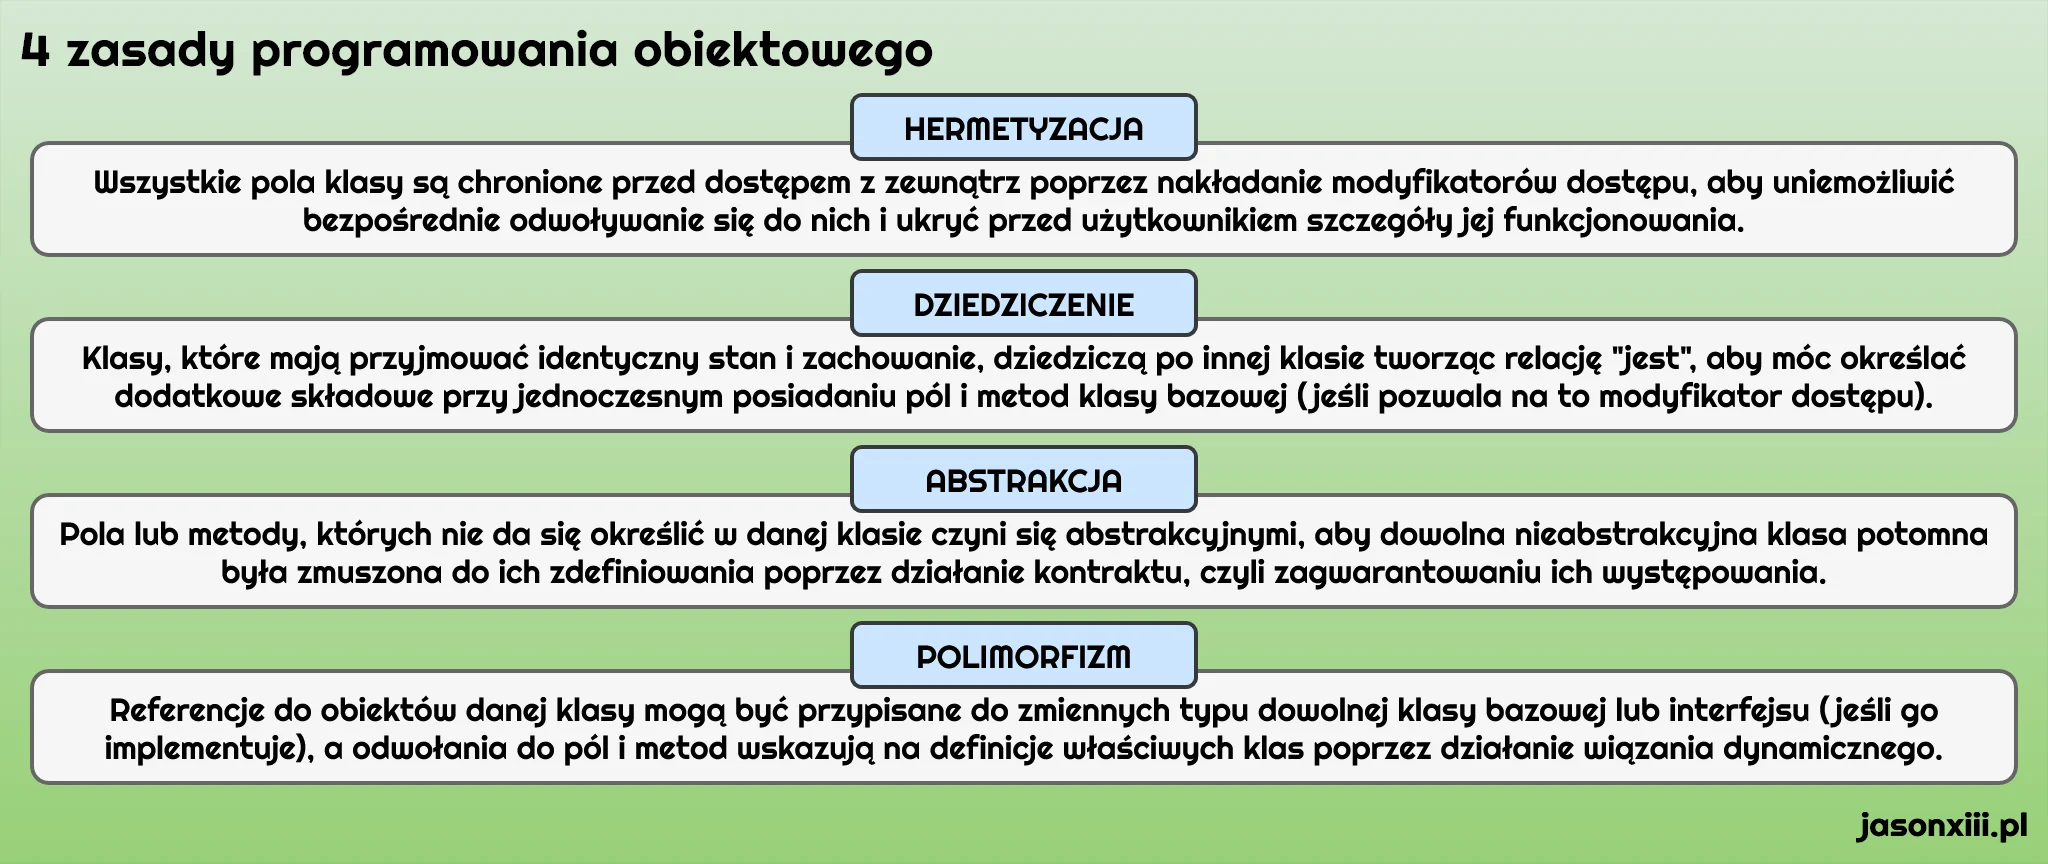 |
To są 4 zasady programowania obiektowego, których znajomość jest niezbędna, aby móc skorzystać z jego pełnego potencjału!
Skończyłem. Mam nadzieję, że pomyślnie streściłem Tobie 4 zasady programowania obiektowego, których rozumienie jest wysoce zalecane, aby poprawnie pisać kod źródłowy w tym paradygmacie 👍. Pamiętaj, że to nie są jedyne zasady jakie istnieją i dotyczą dobrych praktyk ⚠️. W obiektowości występuje też wspomniany mnemonik SOLID i to jest przykład kolejnej "paczki" reguł wśród kilku innych, jakimi warto się kierować. A to wszystko sprowadza się do drastycznego zwiększenia jakości kodu źródłowego, w szeroko pojętym zakresie tego określenia 🔥!